找回密碼
 立即註冊
搜索
熱搜: 活動 交友 discuz
Close
查看: 99|回復: 0

谷歌发布“Vlogger”模型:单张图片生成10秒视频

[複製鏈接]

14

主題

0

回帖

52

積分

註冊會員

積分
52
發表於 2024-3-20 17:20:26 | 顯示全部樓層 |閱讀模式
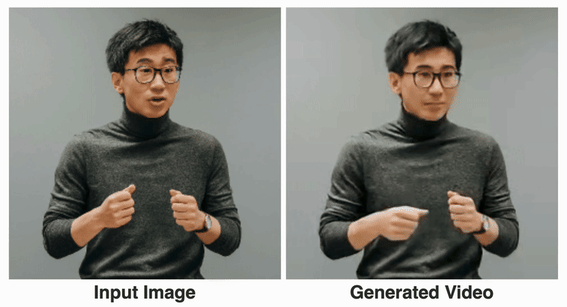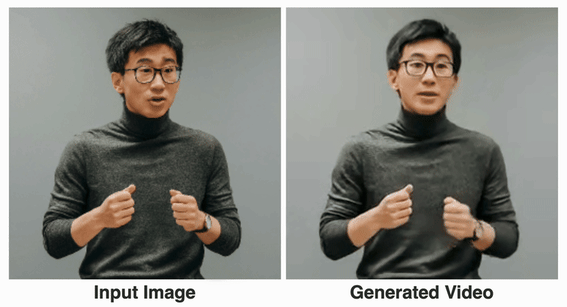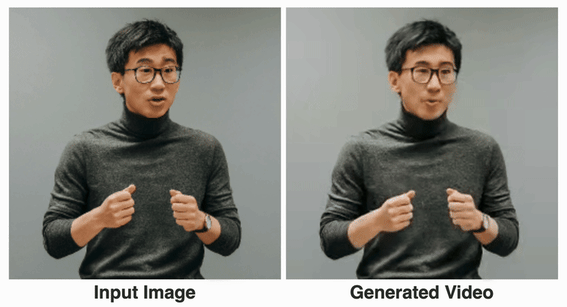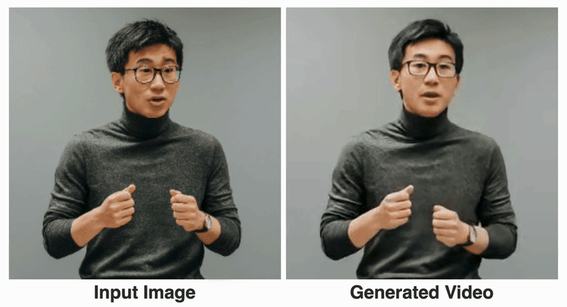
谷歌发布了一个新的视频框架:只需要一张你的头像、一段讲话录音,就能得到一个本人栩栩如生的演讲视频。视频时长可变,目前看到的示例最高为10s。可以看到,无论是口型还是面部表情,它都非常自然。如果输入图像囊括整个上半身,它也能配合丰富的手势:


网友看完就表示:有了它,以后咱开线上视频会议再也不需要整理好发型、穿好衣服再去了。嗯,拍一张肖像,录好演讲音频就可以(手动狗头)用声音控制肖像生成视频这个框架名叫VLOGGER。它主要基于扩散模型,并包含两部分:一个是随机的人体到3D运动(human-to-3d-motion)扩散模型。另一个是用于增强文本到图像模型的新扩散架构。其中,前者负责将音频波形作为输入,生成人物的身体控制动作,包括眼神、表情和手势、身体整体姿势等等。后者则是一个时间维度的图像到图像模型,用于扩展大型图像扩散模型,使用刚刚预测的动作来生成相应的帧。为了使结果符合特定的人物形象,VLOGGER还将参数图像的pose图作为输入。VLOGGER的训练是在一个超大的数据集(名叫MENTOR)上完成的。有多大?全长2200小时,共包含80万个人物视频。其中,测试集的视频时长也有120小时长,共计4000个人物。谷歌介绍,VLOGGER最突出的表现是具备多样性:如下图所示,最后的像素图颜色越深(红)的部分,代表动作越丰富。


而和业内此前的同类方法相比,VLOGGER最大的优势则体现在不需要对每个人进行训练、也不依赖于面部检测和裁剪,并且生成的视频很完整(既包括面部和唇部,也包括肢体动作)等等。
具体来看,如下表所示:

Face Reenactment方法无法用音频和文本来控制此类视频生成。Audio-to-motion倒是可以音频生成,方式也是将音频编码为3D人脸动作,不过它生成的效果不够逼真。Lip sync可以处理不同主题的视频,但只能模拟嘴部动作。对比起来,后面的两种方法SadTaker和Styletalk表现最接近谷歌VLOGGER,但也败在了不能进行身体控制上,并且也不能进一步编辑视频。
说到视频编辑,如下图所示,VLOGGER模型的应用之一就是这个,它可以一键让人物闭嘴、闭眼、只闭左眼或者全程睁眼:


另一个应用则是视频翻译:例如将原视频的英语讲话改成口型一致的西班牙语。网友吐槽最后,“老规矩”,谷歌没有发布模型,现在能看的只有更多效果还有论文。嗯,吐槽也是不少的:画质模型、口型抽风对不上、看起来还是很机器人等等。因此,有人毫不犹豫打上差评:这就是谷歌的水准吗?
有点对不起“VLOGGER”这个名字了。
——和OpenAI的Sora对比,网友的说法确实也不是没有道理。。大家觉得呢?更多效果:https://enriccorona.github.io/vlogger/完整论文:https://enriccorona.github.io/vlogger/paper.pdf

免責聲明:如侵犯您的權益敬請通知刪除。

本帖子中包含更多資源

您需要 登錄 才可以下載或查看,沒有賬號?立即註冊

×
您需要登錄後才可以回帖 登錄 | 立即註冊

本版積分規則

更多主題

QQ|小黑屋|隱私權政策|服務條款內容|手機版|Archiver|AI社區-互相幫助共同進步- |網站地圖

GMT+8, 2026-10-9 18:31 , Processed in 0.073884 second(s), 28 queries .

您的到來,讓本站更精彩

快速回復 返回頂部 返回列表