神经网络是机器学习技术中一类具体算法分枝,通过堆叠基本措置单元形成宽度和深度,构建出一个带拓扑布局的高度复杂的非凸函数,对蕴含在各类数据分布中的统计规律进行拟合。传统机器学习方式在面对分歧应用时,为了达到所需的学习效果往往需要从头选择函数空间设计新的学习方针。
对比之下,神经网络方式能够通过调节构成网络使用的措置单元,措置单元之间的堆叠方式,以及网络的学习算法,用一种较为统一的算法设计视角解决各类应用任务,很大程度上减轻了机器学习算法设计的选择困难。同时,神经网络能够拟合海量数据,深度学习方式在图像分类,语音识别以及自然语言措置任务中取得的打破性进展,揭示了构建更大规模的神经网络对大规模数据进行学习,是一种有效的学习策略。
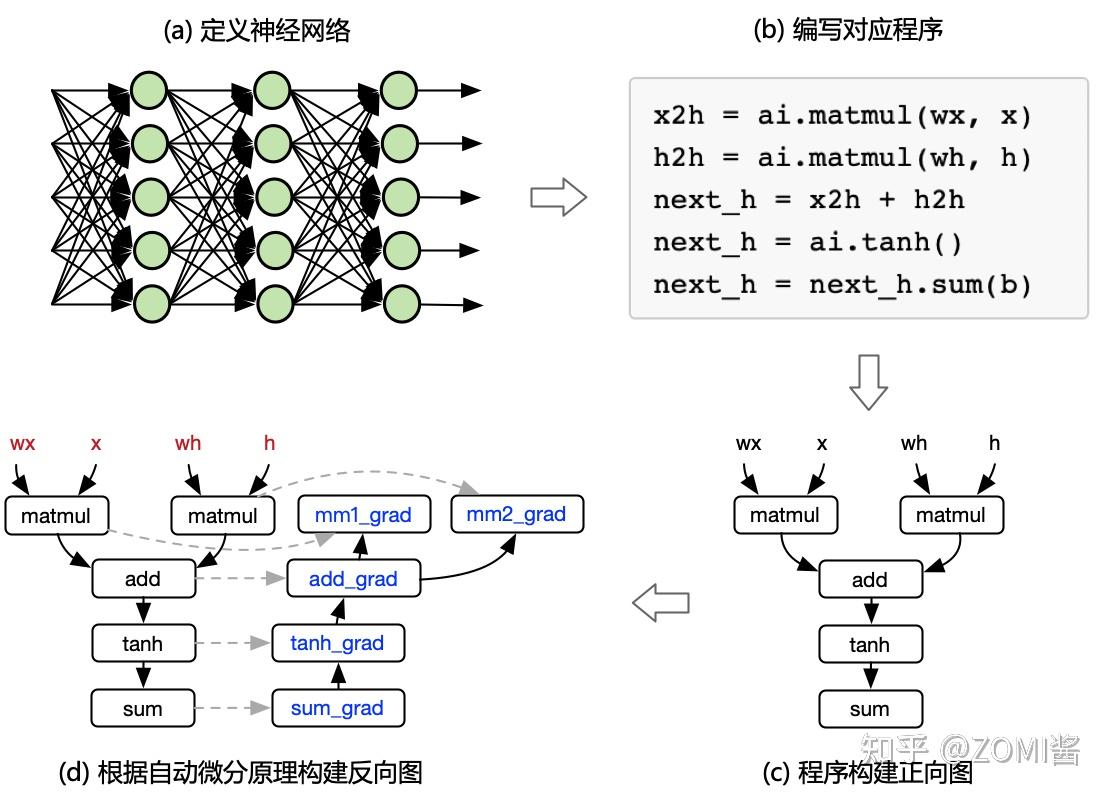
然而,深度神经网络应用的开发需要对软件栈的各个抽象层进行编程,这对新算法的开发效率和算力都提出了很高的要求,进而催生了 AI 框架的成长。AI框架可以让开发者更加专注于应用法式的业务逻辑,而不需要存眷底层的数学和计算细节。同时AI框架凡是还提供可视化的界面,使得开发者可以更加便利地设计、训练和优化本身的模型。在AI框架之上,还会提供了一些预训练的网络模型,可以直接用于一些常见的应用场景,例如图像识别、语音识别和自然语言措置等。
AI 框架的目的是为了在计算加速硬件(GPU/NPU)和AI集群上高效训练深度神经网络而设计的可编程系统,需要同时兼顾以下互相制约设计方针可编程性与性能。
1. 提供灵活的编程模型和编程接口
AI 框架作为智能经济时代的中枢,是 AI 开发环节中的基础东西,承担着 AI 技术生态中操作系统的角色,是 AI 学术创新与财富商业化的重要载体,助力 AI 由理论走入实践,快速进入了场景化应用时代,也是成长 AI 所必需的基础设施之一。随着重要性的不竭凸显,AI 框架已经成为了 AI 财富创新的焦点之一,引起了学术界、财富界的重视。
时间维度
结合 AI 的成长历程,AI 框架在时间维度的成长大致可以分为四个阶段,分袂为1)2000 年初期的萌芽阶段、2)2012~2014年的成长阶段、3)2015 年~2019 年的爆发阶段,和4)2020 年以后深化阶段。
其在时间的成长脉络与 AI ,出格是深度学习范式下的神经网络技术的异峰突起有非常紧密的联系。
萌芽阶段
在2020年前,早期受限于计算能力不足,萌芽阶段神经网络技术影响力相对有限,因而呈现了一些传统的机器学习东西来提供基本撑持,也就是 AI 框架的雏形,但这些东西或者不是专门为神经网络模型开发定制的,或者 API 极其复杂对开发者并不友好,且并没有对异构加速算力(如GPU/NPU等)进行撑持。错误谬误在于萌芽阶段的 AI 框架并不完善,开发者需要编写大量基础的工作,例如手写反向传布、搭建网络布局、自行设计优化器等。
其以 Matlab 的神经网络库为代表作品。
成长阶段
2012 年,Alex Krizhevsky 等人提出了 AlexNet 一种深度神经网络架构,在 ImageNet 数据集上达到了最佳精度,并碾压第二名提升15%以上的准确率,引爆了深度神经网络的热潮。
自此极大地敦促了 AI 框架的成长,呈现了 Caffe、Chainer 和 Theano 等具有代表性的早期 AI 框架,辅佐开发者便利地成立复杂的深度神经网络模型(如 CNN、RNN、LSTM 等)。不仅如此,这些框架还撑持多 GPU 训练,让开展更大、更深的模型训练成为可能。在这一阶段,AI 框架体系已经初步形成,声明式编程和命令式编程为下一阶段的 AI 框架成长的两条截然分歧的道路做了铺垫。
随着 AI 的进一步成长,AI 应用场景的扩展以及与更多范围交叉融合进程的加快,新的趋势不竭涌现,越来越多的需求被提出。
例如超大规模模型的呈现(GPT-3、ChatGPT等),新的趋势给 AI 框架提出了更高的要求。例如超大规模模型的呈现(GPT-3、ChatGPT等);如对全场景多任务的撑持、对异构算力撑持等。这就要求 AI 框架最大化的实现编译优化,更好地操作算力、调动算力,充实阐扬集群硬件资源的潜力。此外,AI 与社会伦理的痛点问题也促使可信赖 AI 、或则 AI 安全在 AI 框架层面的进步。
基于以上布景,现有的主流 AI 框架都在探索下一代 AI 框架的成长标的目的,如 2020 年华为推出昇思 MindSpore,在全场景协同、可信赖方 面有必然的打破;旷视推出天元 MegEngine,在训练推理一体化方面深度布局;PyTorch 捐赠给 Linux 基金会,并面向图模式提出了新的架构和新的版本 PyTorch2.X。
在这一阶段,AI 框架正向着全场景撑持、大模型、分布式AI、 超大规模 AI、安全可信 AI 等技术特性深化探索,不竭实现新的打破。
技术维度
以技术维度的角度去对 AI 框架进行划分,其主要经历了三代架构,其与深度学习范式下的神经网络技术成长和编程语言、及其编程体系的成长有着紧密的关联。
第一代AI框架
第一代 AI 框架在时间上主要是在 2010 年前,面向需要解决问题有:1)机器学习 ML 中缺乏统一的算法库,2)提供不变和统一的神经网络 NN 定义。其对应的AI框架框架其实广义上并不能称为 AI 框架,更多的是对机器学习中的算法进行了统一的封装,并在必然程度上提供了少量的神经网络模型算法和API的定义。具体形态有2种:
第一种的主要特点的是以库(Library)的方式对外提供脚本式编程,便利开发者通过简单配置的形式定义神经网络,而且针对特殊的机器学习 ML、神经网络NN算法提供接口,其斗劲具有代表性意义的是 MATLAB 和 SciPy。此外还有针对矩阵计算提供特定的计算接口的 NumPy。长处是:面向 AI 范围提供了必然程度的可编程性;撑持CPU加速计算。
第二种的在编程方面,以CNN网络模型为主,由常用的layers组成,如:Convolution, Pooling, BatchNorm, Activation等,都是以Layer Base为驱动,可以通过简单配置文件的形式定义神经网络。模型可由一些常用layer构成一个简单的图,AI 框架提供每一个layer及其梯度计算实现。这方面具有代表性的作品是 Torch、Theano 等AI框架。其长处是提供了必然程度的可编程性,计算性能有必然的提升,部门撑持 GPU/NPU 加速计算。
同时,第一代 AI 框架的错误谬误也斗劲明显,主要集中在1)灵活性和2)面向新场景撑持不足。
首先是易用性的限制难以满足深度学习的快速成长,主要是层出不穷的新型网络布局,新的网络层需要从头实现前向和后向计算;其次是第一代 AI 框架大部门使用非高级语言实现,改削和定制化成本较高,对开发者不友好。最后是新优化器要求对梯度和参数进行更通用复杂的运算。
随着生成对抗网络模型 GAN、深度强化学习 DRL、Stable Diffusion 等新的布局呈现,基于简单的“前向+后向”的训练模式难以满足新的训练模式。例如循环神经网络 LSTM 需要引入控制流、对抗神经网络 GAN 需要两个网络交替训练,强化学习模型 RL 需要和外部环境进行交互等众多场景没法子满足新涌现的场景。
第二代AI框架
第二代AI框架在技术上,统一称为基于数据流图(DAG)的计算框架:将复杂的神经网络模型,按照数据流拆解为若干措置环节,构建数据流图,数据流图中的措置环节彼此独立,撑持混合编排控制流与计算,以任务流为最终导向,AI 框架将数据流图转换为计算机可以执行或者识此外任务流图,通过执行引擎(Runtime)解析任务流进行措置环节的分发调剂、监控与成果回传,最终实现神经网络模型的构建与运行。
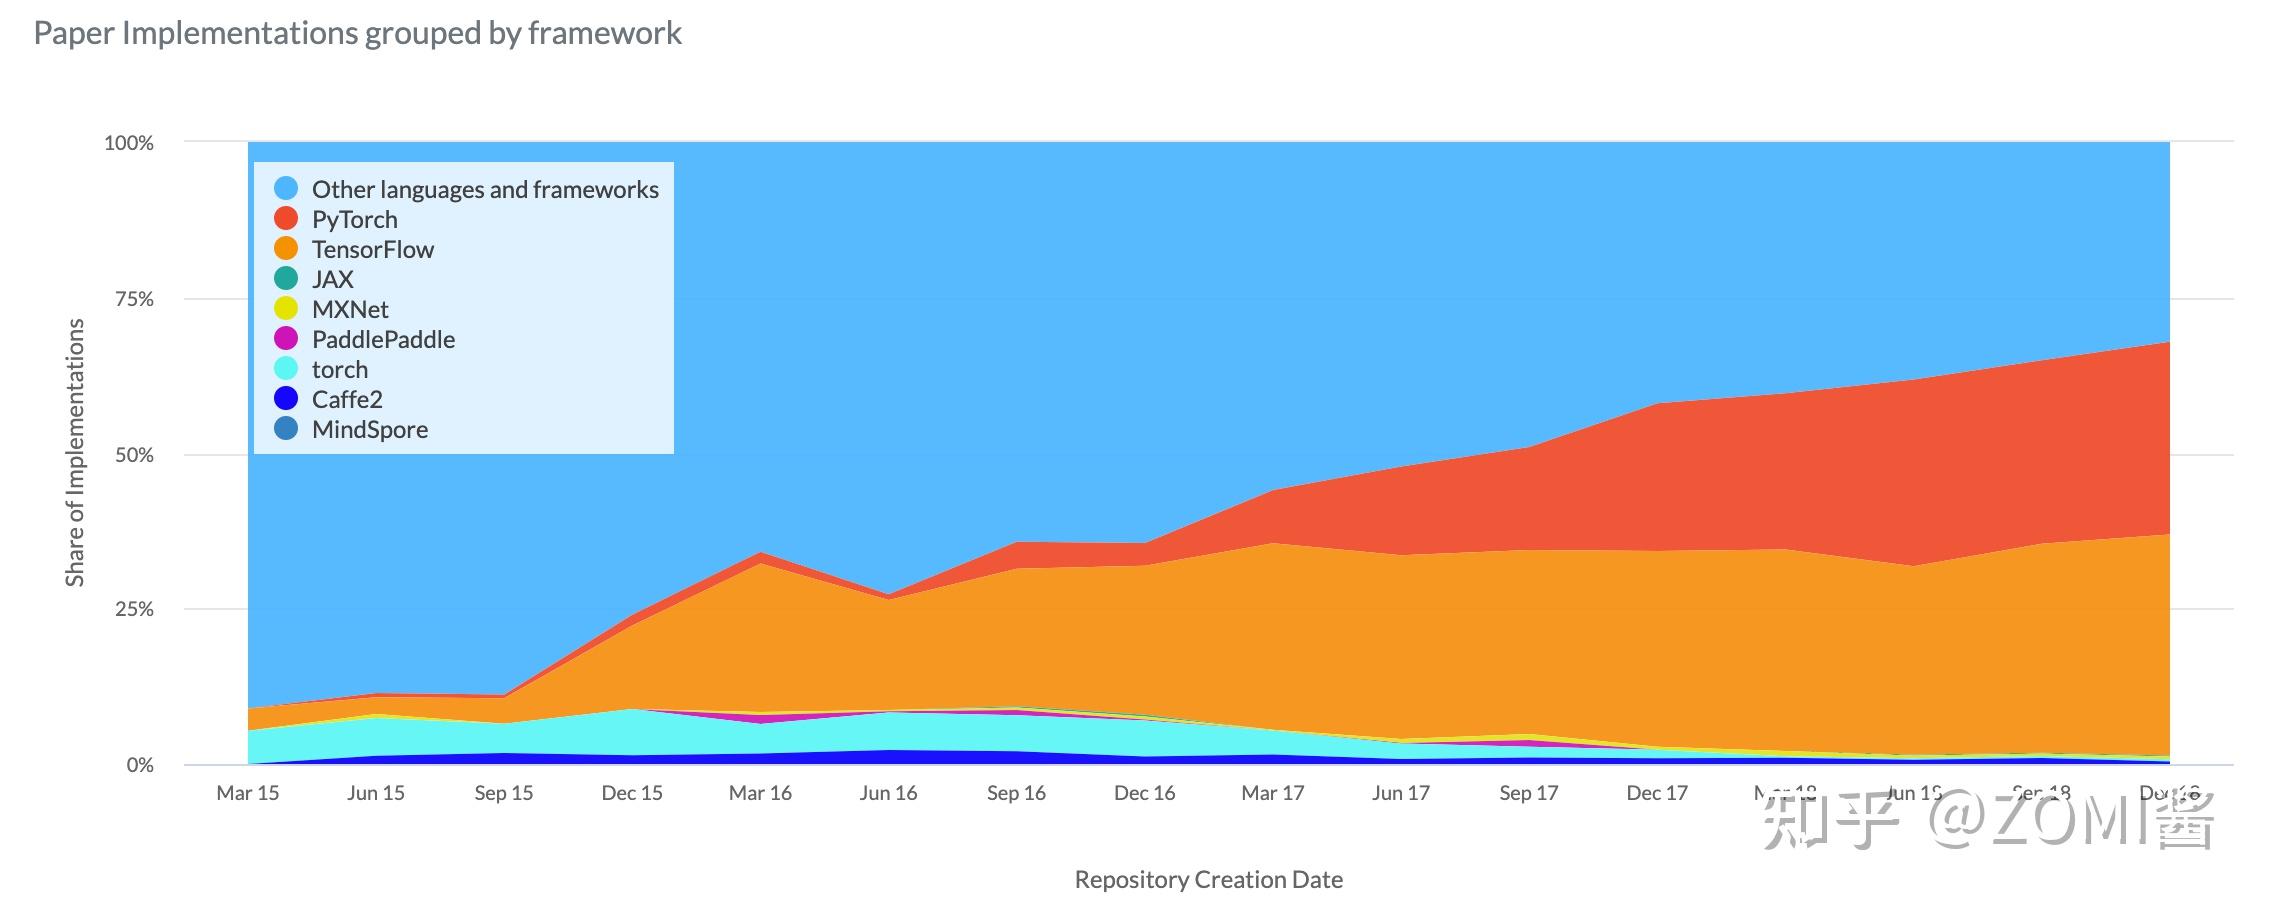
以数据流图描述深度神经网络,前期实践最终催生出了工业级 AI 框架,如TensorFlow 和PyTorch,这一时期同时伴随着如Chainer,DyNet等激发了 AI 框架设计灵感的诸多尝试项目。TensorFlow 和 PyTorch 代表了现今 AI 框架框架的两种分歧的设计路径:系统性能优先改善灵活性,和灵活性易用性优先改善系统性能。
这两种选择,随着神经网络算法研究和应用的更进一步成长,又逐步造成了 AI 框架在具体技术实现方案的分裂。
第三代AI框架
在第三代 AI 框架中,面向通用化场景,如 CNN、LSTM、RNN 等场景开始走向统一的设计架构,分歧的AI框架在必然程度城市仿照或者参考 PyTorch 的动态图 Eager 模式,提升自身框架的易用性,使其更好地接入 AI 生态中。
目前在技术上必然程度开始迈进第三代AI框架,其主要面向设计特定范围语言(Domain-Specific Language,DSL)。最大的特性是:1)兼顾编程的灵活性和计算的高效性;2)提高描述神经网络算法表达能力和编程灵活性;3)通过编译期优化技术来改善运行时性能。
具体面向分歧的业务场景会有一些差异(即特定范围),如 JAX 是 Autograd 和 XLA 的结合,作为一个高性能的数值计算库,更是结合了可组合的函数转换库,除了可用于AI场景的计算,更重要的是可以用于高性能机器学习研究。例如Taichi面向图形图像可微分编程,作为开源并行计算框架,可以用于云原生的3D内容创作。
AI框架的未来
应对未来多样化挑战,AI 框架有以下技术趋势:
全场景
AI 框架将撑持端边云全场景跨平台设备部署
网络模型需要适配部署到端边云全场景设备,对 AI 框架提出了多样化、复杂化、碎片化的挑战。随着云处事器、边缘设备、终端 设备等人工智能硬件运算设备的不竭涌现,以及各类人工智能运算库、中间暗示东西以及编程框架的快速成长,人工智能软硬件生态呈现多样化成长趋势。
但目前主流 AI 框架仍然分为训练部门和推理部门,两者不完全兼容。训练出来的模型也不能通用,学术科研项目间难以合作延伸,造成了 AI 框架的碎片化。目前业界并没有统一的中间暗示层尺度,导致各硬件厂商解决方案存在必然差异,以致应用模型迁移不畅,增加了应用部署难度。因此,基于AI框架训练出来的模型进行尺度化互通将是未来的挑战。
易用性
AI 框架将注重前端便捷性与后端高效性的统一
AI 框架需要提供更全面的 API 体系以及前端语言撑持转换能力,从而提升前端开发便捷性。AI 框架需要能为开发者提供完备度 高、性能优异、易于理解和使用的 API 体系。
AI 框架需要提供更为优质的动静态图转换能力,从而提升后端运行高效性。从开发者使用 AI 框架来实现模型训练和推理部署的角度看,AI 框架需要能够通过动态图的编程范式,来完成在模型训练的开发阶段的灵活易用的开发体验,以提升模型的开发效率;通过静态图的方式来实现模型部署时的高性能运行;同时,通过动态图转静态图的方式,来实现便利的部署和性能优化。目前 PyTorch2.0 的图编译模式走在业界前列,不必然成为最终形态,在性能和易用性方面的兼顾仍然有待进一步探索。
大规模分布式
AI 框架将出力强化对超大规模 AI 的撑持
OpenAI 于 2020 年 5 月发布 GPT-3 模型,包含 1750 亿参数,数据集(措置前)达到 45T, 在多项 NLP 任务中超越了人类程度。随之 Google 不竭跟进分布式技术,超大规模 AI 逐渐成为新的深度学习范式。
超大规模 AI 需要大模型、大数据、大算力的三重撑持,对 AI 框架也提出了新的挑战,
内存:大模型训练过程中需要存储参数、激活、梯度、优化器状态,
算力:2000 亿参数量的大模型为例,需要 3.6EFLOPS 的算力撑持,必要构建 AI 计算集群满足算力需求
通信:大模型并行切分到集群后,模型切片之间会发生大量通信,从而通信就成了主要的瓶颈
调优:E 级 AI 算力集群训练千亿参数规模,节点间通信复杂,要保证计算正确性、性能和可用性,手动调试难以全面兼顾,需要更自动化的调试调优手段部署:超大规模 AI 面临大模型、小推理部署难题,需要对大模型进行完美压 缩以适应推理侧的部署需求
科学计算
AI框架将进一步与科学计算深度融合交叉
传统科学计算范围亟需 AI 技术加持融合。计算图形可微编程,类似Taichi这样的语言和框架,提供可微物理引擎、可微衬着引擎等新功能。因此未来是一个AI与科学计算融合的时代,传统的科学计算将会结合AI的方式去求解既定的问题。至于AI与科学计算结合,看到业界在探索三个标的目的:
操作 AI 神经网络进行建模替代传统的计算模型或者数值模型,目前已经有很大的进展了,如拿了戈登贝尔奖的分子动力学模型DeepMD。
AI求解,模型还是传统的科学计算模型,但是使用深度学习算法来求解,这个标的目的已经有必然的探索,目前看到不少基础的科学计算方程已经有对应的AI求解方式,比如PINNs、PINN-Net等,当然此刻挑战还很大,出格是在精度收敛方面,如果要在AI框架上使用AI求解科学计算模型,最大的挑战主要在前端表达和高性能的高阶微分。
使用AI框架来加速方程的求解,科学计算的模型和方式都不变的前提下,与深度学习使用同一个框架来求解,其实就是把AI框架当作面向张量计算的通用分布式计算框架。


 發表於 2023-7-20 09:32:54